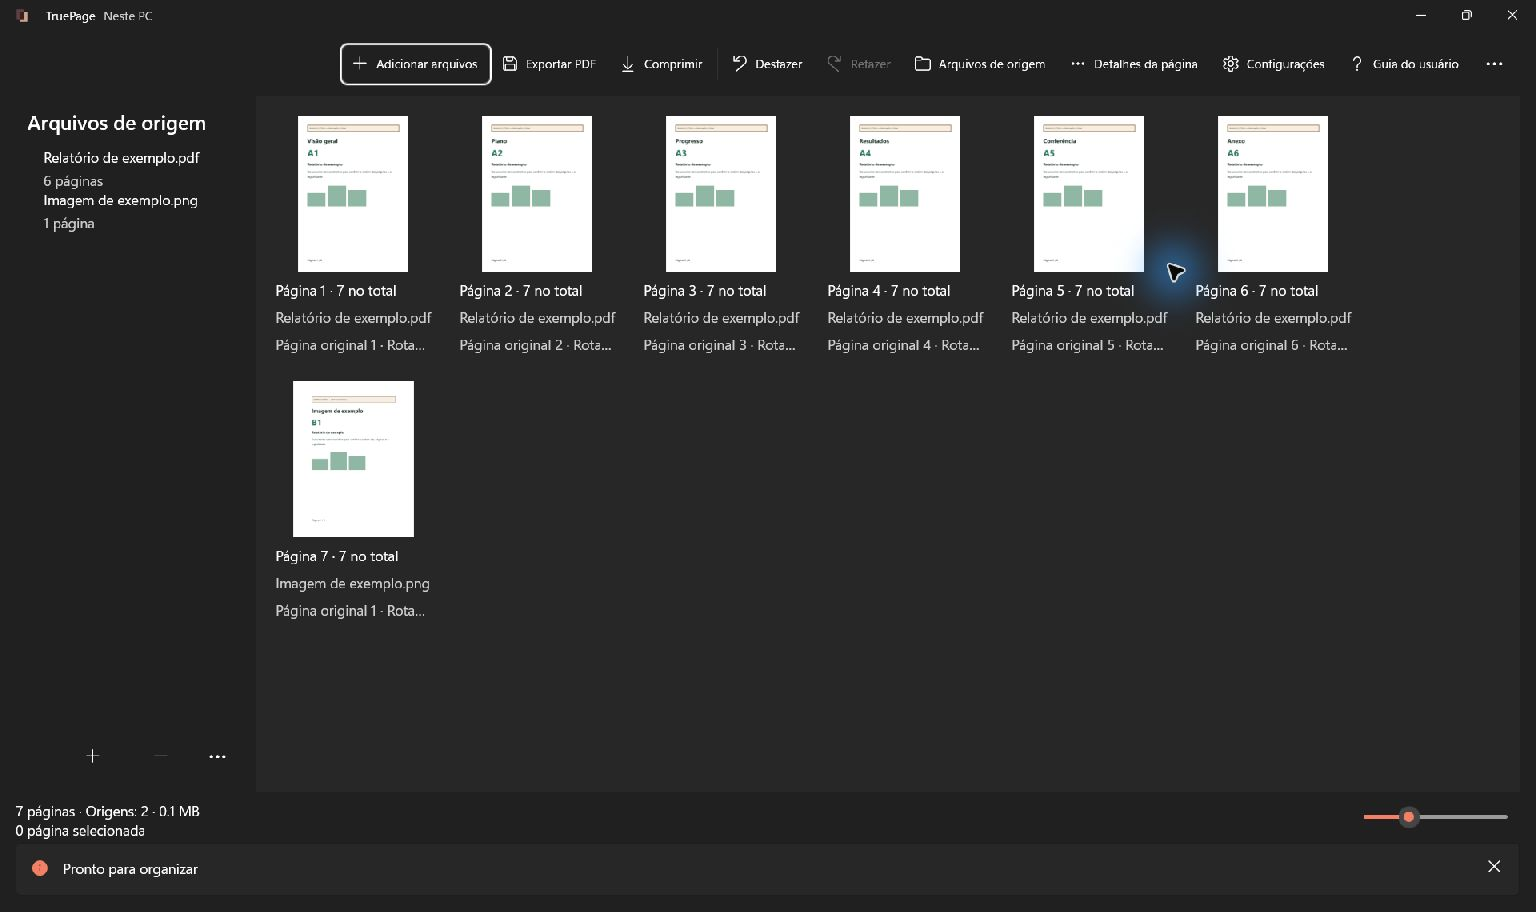
Uma palavra visível nem sempre está armazenada como texto
Uma página digitalizada pode conter apenas uma imagem das palavras. O TruePage não adiciona OCR ao organizar ou exportar. Prepare um PDF legível, use uma ferramenta OCR e confira o texto reconhecido.
Diferencie três situações comuns
Um PDF criado a partir de um documento textual pode conter objetos de texto reais. Um leitor geralmente permite selecioná-los e pesquisar, embora cópia e ordem de leitura dependam da criação do arquivo. Página visível e texto armazenado são relacionados, mas não idênticos.
Uma digitalização somente de imagem contém uma fotografia da página. As marcas semelhantes a letras são pixels. O visualizador pode exibi-las claramente sem ter uma sequência de caracteres para buscar. Ampliar ajuda a observar, não transforma pixels em texto.
Um PDF digitalizado com OCR pode combinar imagem e texto reconhecido. A aparência pode ficar igual enquanto uma camada textual permite seleção e pesquisa. Esse texto pode ter erros. Encontrar uma palavra demonstra disponibilidade de texto, não uma transcrição perfeita.
Um documento pode misturar esses casos. A primeira página pode vir de um editor de texto e as seguintes ser fotos de recibos. Encontrar um título no começo não prova que todos os anexos permitem busca.
Teste em um leitor com pesquisa textual
Abra a saída em um aplicativo que permita selecionar e pesquisar texto. Escolha uma palavra distinta visível e procure. Depois tente copiar uma frase curta para um campo de texto simples sob seu controle.
Teste várias palavras e páginas. Uma palavra pode estar quebrada, codificada de forma incomum ou reconhecida incorretamente. Um único fracasso não demonstra que todo o documento é imagem; um acerto também não comprova texto útil em todas as páginas.
Examine o que foi copiado: caracteres, espaços, quebras e possíveis colunas misturadas. Assim diferencia a mera existência de objetos de texto de um texto que atende ao leitor.
Se não houver seleção, considere o comportamento do visualizador e as restrições do arquivo. A prévia do TruePage serve para inspecionar páginas, não para medir precisão OCR. Faça os testes em um leitor com os recursos necessários.
Por que exportar novamente não resolve
Um JPG ou PNG adicionado vira uma página de imagem. Exportar a montagem em PDF incorpora essa imagem ao resultado. Não examina grupos de pixels para atribuir caracteres automaticamente.
O mesmo vale para um PDF fonte só de imagens. Reordenar, remover e girar altera a composição, sem criar uma camada de texto reconhecido para as palavras digitalizadas.
Trocar a extensão também não acrescenta caracteres. Um PDF de imagens precisa de reconhecimento quando se exige texto pesquisável. A próxima operação útil é OCR em uma ferramenta compatível, não outra exportação da composição.
Comprimir tem outra finalidade: reduzir armazenamento, não reconhecer palavras. Os modos do TruePage não são opções OCR. Um PDF de imagens menor permanece assim até outro processo adicionar texto.
Melhore a origem antes do reconhecimento
Confira borrões, bordas faltantes, sombras e inclinação na digitalização original. O OCR trabalha com o material disponível. Rodapés ausentes e caracteres ilegíveis não voltam de maneira confiável apenas solicitando mais pixels.
Examine letras pequenas além da folha inteira. Uma digitalização limpa à primeira vista pode deixar caracteres parecidos ambíguos. Datas, referências, pontuação e separadores decimais merecem cuidado quando são importantes.
Se puder refazer a captura, inclua a folha completa com detalhes legíveis. Para corrigir perspectiva ou preparar a imagem, trabalhe em uma cópia em editor apropriado. Guarde o original para comparar e evitar perda de informação.
Aumentar DPI não inventa detalhes em uma fonte borrada. Produz mais pixels, mas o conteúdo de origem limita o que eles representam. Uma entrada melhor vale mais que uma versão maior do mesmo defeito.
Organize as páginas antes do OCR
O TruePage pode preparar um documento coerente para outro fluxo. Adicione fontes, defina ordem, retire ocorrências extras e gire páginas laterais. Confira o conjunto antes de entregá-lo à ferramenta seguinte.
Escolha a sequência pelo conteúdo, não só por nomes. Digitalizações podem ter capa, anexos e numeração própria. Leia as transições entre origens e compare o total com o esperado.
Para imagens importadas diretamente, use Layout das páginas de imagem para papel, margens e colocação. Ajustar mantém o conteúdo completo. Preencher (recortar) pode esconder bordas com palavras necessárias ao reconhecimento.
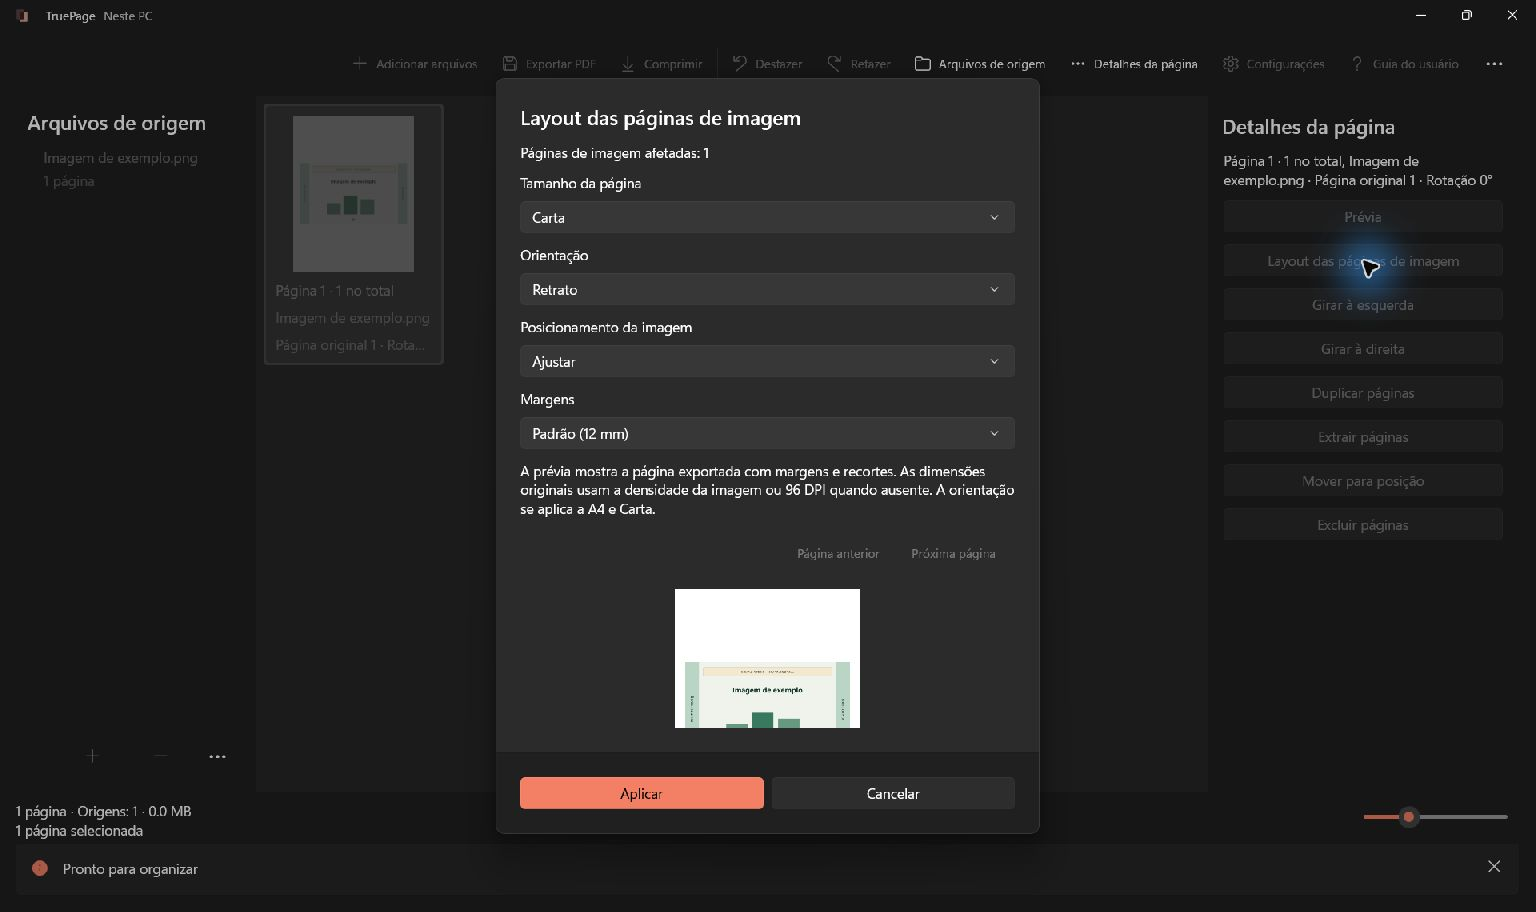
Revise todas após aplicar ajustes compartilhados. Formas distintas podem resultar em layouts diferentes. Os controles de imagem não reformulam páginas PDF, mesmo quando elas contêm digitalizações.
Exporte uma entrada OCR identificável
Escolha Exportar PDF e confirme o escopo. Todas as páginas usa a montagem inteira; Páginas selecionadas usa a seleção atual. Confira páginas e arquivos antes de salvar a entrada do OCR.
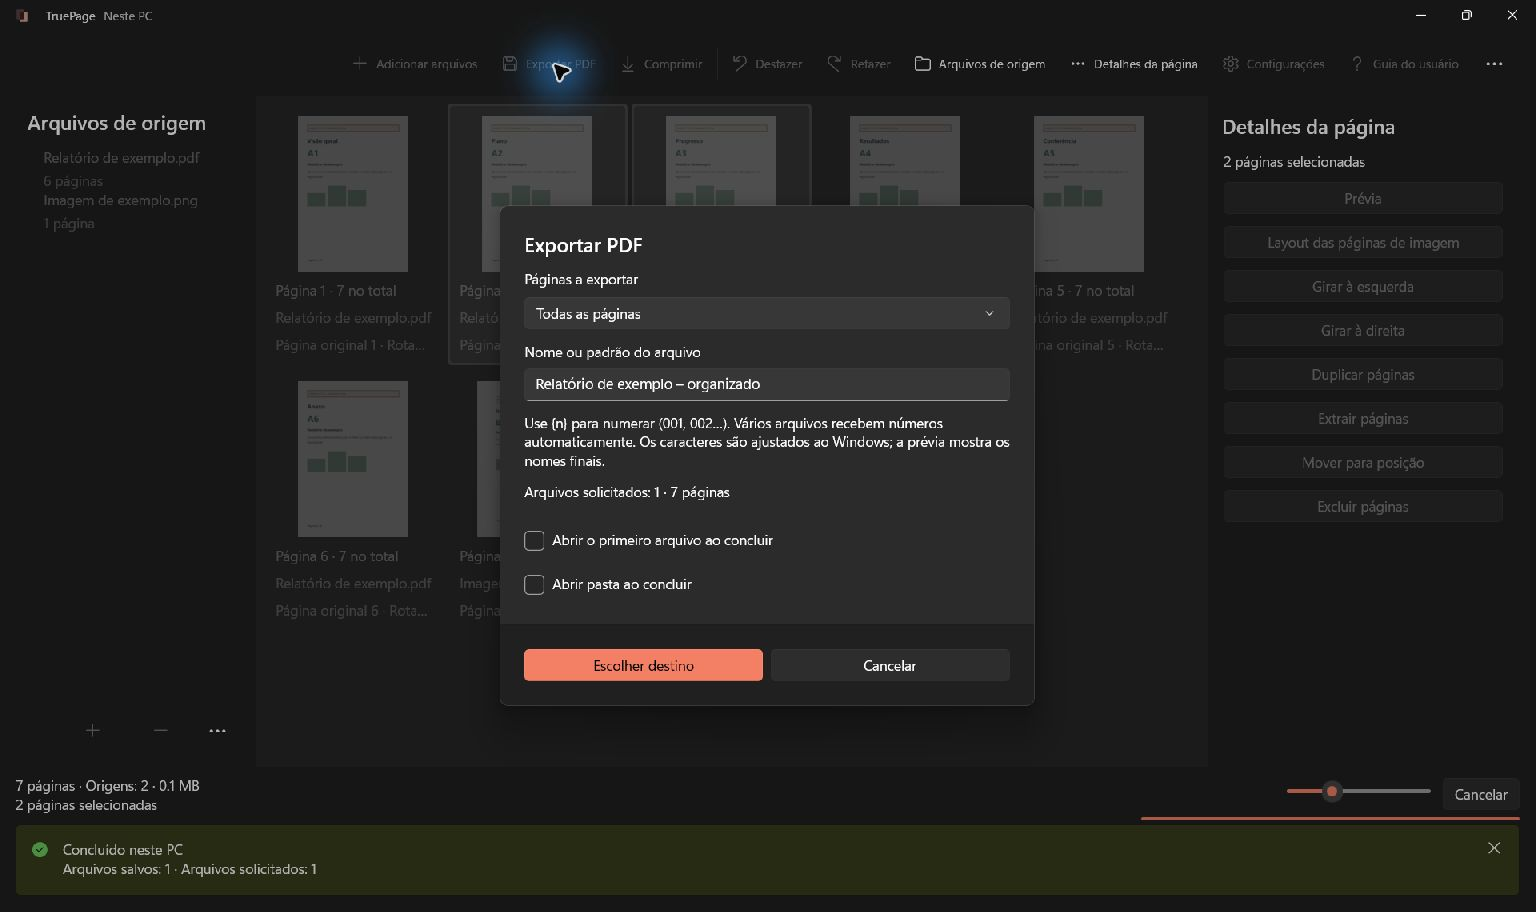
Use nomes distintos para entrada preparada e saída reconhecida, como conjunto-organizado e conjunto-pesquisavel. Os nomes descrevem etapas, não provam sucesso. Confira o conteúdo antes de considerar o segundo corretamente reconhecido.
Abra a entrada e revise ordem, orientação, limites e leitura. Assim evita reconhecer uma montagem com página errada ou anexo ausente.
Mantenha essa cópia durante a avaliação OCR. Se o processamento alterar a aparência ou introduzir problemas, a entrada organizada fornece uma referência clara sem reconstruir o conjunto.
Escolha a saída OCR conforme o uso
Na ferramenta compatível, selecione os idiomas adequados e examine os formatos de saída. Um PDF pesquisável que mantém a imagem tem finalidade diferente de um documento textual editável. Use o que o destinatário precisa.
Verifique se a ferramenta processa localmente ou envia arquivos a um serviço antes de usá-la com conteúdo que deve permanecer no computador. Essa decisão pertence ao fluxo OCR. O trabalho local no TruePage não determina como outra aplicação trata o arquivo.
Com vários idiomas, tabelas e layouts incomuns, planeje uma revisão mais atenta. Reconhecimento e ordem de leitura são assuntos diferentes. Palavras corretas podem ser copiadas em uma sequência inadequada a partir de colunas ou posições complexas.
Não considere um PDF pesquisável automaticamente acessível ou completamente reconstruído para edição. A pesquisa textual é um recurso. Ordem, estrutura e exigências do leitor ou sistema podem precisar de outras etapas.
Compare o texto reconhecido com a página
Abra o resultado OCR e repita busca e cópia. Teste partes diferentes, incluindo a digitalização mais difícil. Compare caracteres com a imagem em vez de confiar apenas em uma mensagem de conclusão.
Revise nomes, números, datas e rótulos curtos. Um único caractere errado pode impedir encontrar uma referência mesmo quando o restante está certo. Mantenha a origem visível durante a conferência.
Confirme quantidade, ordem e bordas necessárias. Um reconhecimento bem-sucedido não deve esconder problemas de montagem. Confira também tamanho e formato depois de salvar.
Se depois exportar páginas como PNG ou JPG, essas saídas serão imagens novamente. Não mantêm a camada textual como texto PDF pesquisável. Guarde o PDF reconhecido para leitores que precisam de busca e use imagens quando uma figura for a entrega esperada.
Os guias imagens para PDF e organizar páginas explicam a preparação. O TruePage organiza o visível, outro fluxo reconhece caracteres e a comparação final determina se o texto é útil e preciso o suficiente para a tarefa.

Suas páginas. Seu espaço.
Já disponível para Windows 11

